
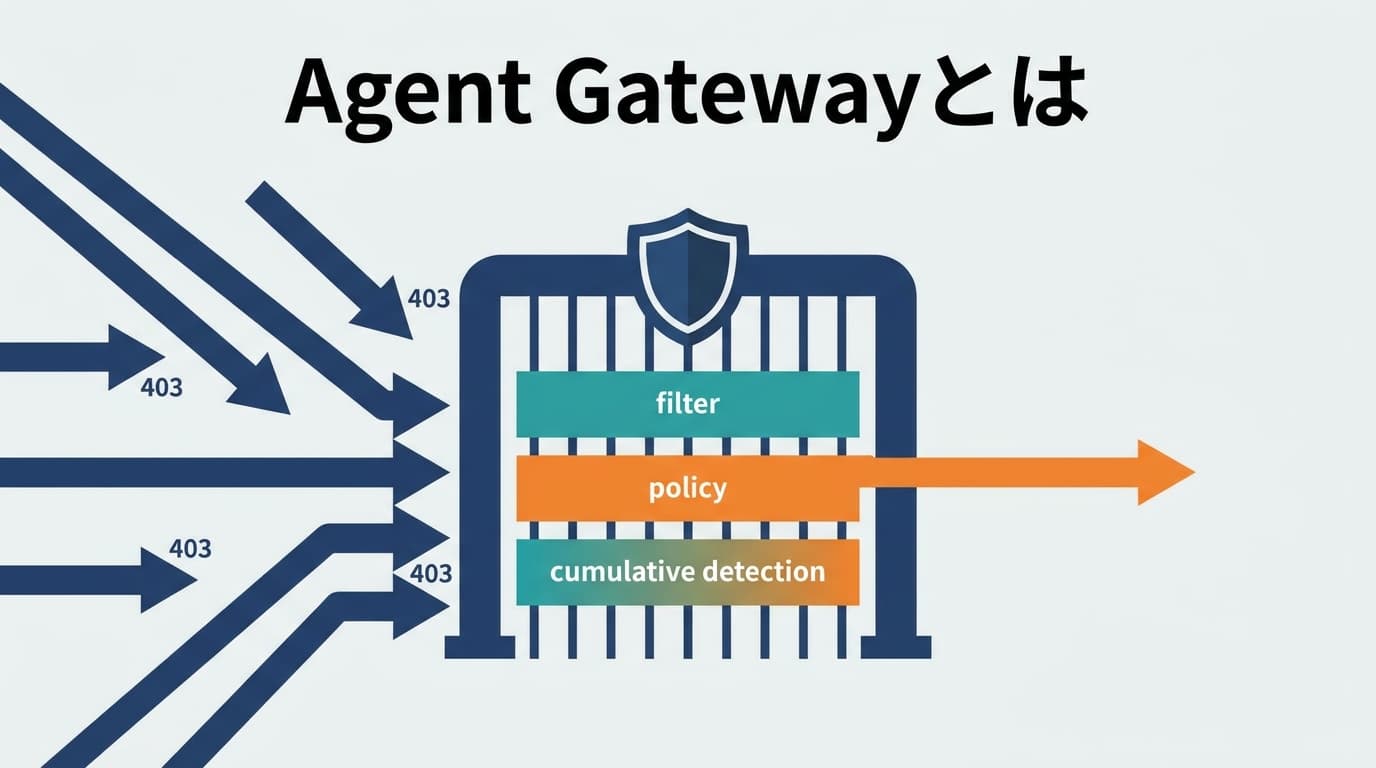
Agent Gatewayとは、AIエージェントの安全対策を個々のエージェントのコードにばらまくのではなく、すべてのツール呼び出しが通る実行時の共通の強制点(ゲートウェイ)に寄せる、Googleが公開した設計です。ポリシーを自然言語で書き、ツール呼び出しの前に意図を審査して、弾く場合はモデルを呼ばずに403を返す。私の結論を先に置くと、この製品自体はGemini Enterprise前提のプラットフォーム機能なので、私の規模の運用では使いません。ただし設計の骨組みは規模に関係なく持ち帰れます。実際、私が毎日回しているSNS・ブログの自動運用は、同じ形をずっと小さいサイズで組んだものでした。
対象読者は、エージェントにツール実行や公開作業を任せる仕組みを設計している実務者です。この記事では、Googleが2026年9月に公開した2本の一次情報——Agent Gatewayのゼロトラスト設計の解説と、Google自身がその既定denyで転んだ摩擦の報告——を突き合わせて、「強制点をどこに置くか」という判断を整理します。
ビルド時の検査は「先に書けた違反」しか捕まえない
出発点は、Googleの解説記事(2026年9月15日公開、2026年9月16日確認)が挙げる問題設定です。エージェントの安全対策としてまず思いつくのは、コードレビュー、権限設定、静的な検査といったビルド時の対策です。ところが原文は、これらの限界をこう言い切ります。
They only catch cases that you can explicitly specify ahead of time
先に明示できたケースしか捕まえられない。つまり、構文としては正しく、権限としても許可されているのに、意図や業務ルールに反している呼び出しは、ビルド時の検査をすり抜けます。「削除APIを正しい引数で呼ぶ」ことと「その削除が今やっていい操作か」は別の問題で、前者しか静的には検査できません。
これは自分の運用でも身に覚えがあります。私はClaude Codeのhooksで、mainへの直接pushのような禁止操作を正規表現で機械的にブロックしていますが、この方式で止まるのも「先にパターンとして書けた違反」だけです。ルールに書いていない、しかし明らかにおかしい呼び出しは素通りします。ルールを増やせば増やすほど網羅した気分にはなりますが、原理的に「事前に書けなかったもの」は残り続ける。この残りをどこで受けるかが、実行時の強制点という話につながります。
Agent Gatewayの3層——弾くときはモデルを呼ばずに403
Googleの設計は、この「事前に書けない違反」への対策を、エージェント側のコードではなくAgent Gatewayという共通の通過点に置きます。すべてのやり取りが単一のdefault-denyの強制点を通る構成で、そこに性質の違う3層を重ねます。
- Model Armor: 入出力のフィルタ。プロンプトや応答に含まれる危険な内容を通過点で落とす層
- Semantic Governance Policies: 自然言語で書いた制約を、ツール呼び出しの前に評価する層。決定的なIAMやIAPの制御を補う位置づけ
- Agent Anomaly Detection: セッションを横断して累積を見る層。単発では正しい呼び出しが、積み重なると異常になるケースを検出する
注目したいのは、弾き方の記述です。原文にはこうあります。
When a filter matches, the request is dropped at the edge with a 403. The agent's model is never invoked
フィルタに一致したリクエストは縁で落とし、エージェントのモデルはそもそも呼ばれない。危険な呼び出しの判定にすらモデルを使わない、という順序です。全部をLLMの判断に乗せるのではなく、確実に落とせるものは決定的に落とし、その内側に意味の審査を置く。この層の分け方は、以前書いた公開前チェックの2層設計とまったく同じ発想です。
Google Developers Blog: Build zero-trust AI agents that judge intent, not just syntaxDiscover how to secure zero-trust AI agents at runtime using Model Armor, Semantic Governance, and Anomaly Detection on the Gemini Enterprise Platform.developers.googleblog.com
もう1つ、運用設計として重要な一文があります。
Governance is defined and managed by a platform or security administrator, separate from the agent developer
ポリシーを書く人と、エージェントを作る人を分ける。エージェント開発者が自分で自分のガードレールを書く構成だと、開発の都合でガードレールも一緒に緩んでいきます。基準の管理者を分離することで、「作る速度」と「守る基準」を別々の意思決定にする。ここは製品の機能というより、組織側の設計指針として読めます。
Google自身が、既定denyで最初に転んでいた
ここまでは設計のきれいな面です。面白いのは、同じdevelopers.googleblog.comに、この設計を自社で検証したときの摩擦がそのまま公開されていることです(2026年9月4日公開、2026年9月6日確認)。Gemini EnterpriseのDeveloper Experienceプログラムがスプリント形式で検証し、見つけた摩擦点を7件挙げています。
その中に、こういう項目があります。
- Agent Gatewayのdefault-denyが、自社プラットフォーム内部の呼び出しをブロックしていた
- ポリシー評価のbind time(束縛時)とruntime(実行時)の区別が不明瞭だった
- Model Armorのコードサンプルにsecure-by-defaultの指針がなかった
- 検証用のログクエリを手で組む必要があった
つまり、default-denyの通過点を1つ置いたとき、最初に止まったのは外部からの攻撃ではなく、自分たちの内部呼び出しだったわけです。設計を提唱している当人がこの順序で転んでいるのは、皮肉ではなく貴重な観測だと思います。ゲートは置いた瞬間から仕事をします。そして最初の仕事は、たいてい正当なトラフィックを止めることです。
7件の中では「bind timeとruntimeの区別が不明瞭」も見過ごせません。ポリシーには、宣言した時点で束ねられて固定されるもの(bind time)と、呼び出しのたびに評価されるもの(runtime)があり、どちらで効いているかが分からないと「書いたのに効かない」「変えたのに反映されない」が延々と起きます。Claude Codeを使っている人なら、settings.jsonのpermissionsルールとhooksの関係で同じ混乱を経験しているはずです。permissionsは宣言的なルールとして解決され、hooksはツール実行のたびにスクリプトが走る。評価のタイミングが違えば「効かないときにどこを見るか」も別物になるので、ルールを書くときに「これはいつ評価されるのか」を先に確認しておくと、この種の混乱を避けられます。Googleほどの規模でもここが摩擦点として挙がるのだから、区別を曖昧にしたまま運用してよい話ではない、と読みました。
報告には対応も書かれています。サンプルをfail-closed(失敗時は閉じる)へ書き換え、Google APIの許可リスト登録を自動化し、コピー&ペーストで使えるLogs Explorerのクエリを公開した。裏を返せば、強制点を運用に乗せるには「何が・なぜ止まったかをすぐ確認できる導線」と「正当な呼び出しを許可リストへ入れる楽な経路」がセットで必要だ、ということです。ゲートの請求書は、セキュリティ費用ではなく摩擦で払うことになります。
Google Developers Blog: Driving developer excellence inside the program sprintsExplore the latest updates from our Gemini Enterprise DevEx sprint. We’ve optimized AI governance, agent security, and developer workflows to deliver a more reliable, friction-free experience.developers.googleblog.com
同じ形を、ずっと小さいサイズで毎日回している
私の運用にAgent Gatewayはありません。ただ、2本の記事を読みながら、3層それぞれに対応する部品を自分がすでに持っていることに気づきました。エージェントにSNSとブログの公開を任せている自動運用の話です。
1つ目、決定的に縁で落とす層。前述のhooksによるBashガードがこれで、禁止コマンドはモデルの判断を待たずに実行前へブロックします。「弾くときはモデルを呼ばない」は、規模が小さくても同じ理屈で効きます。判定が揺れないこと、なぜ止めたかを1行で説明できることが価値だからです。
2つ目、自然言語のポリシーを別の主体が評価する層。公開原稿は、執筆エージェントとは別の読み取り専用サブエージェント(critic)が、ファイルに固定した審査基準に照らしてPASS/FAILを判定します。基準は日本語の箇条書き、つまり自然言語のポリシーです。そして基準ファイルは憲法層として書き手のエージェントからは変更できない運用にしてあり、「ポリシーを書く人と守らされる人を分ける」というGovernance分離の一文と同じ形になっています。
Claude Codeのサブエージェントで公開前レビューを分離する|critic実装記録Claude Codeのサブエージェントで、公開前レビューを執筆エージェントから分離した実装記録。読み取り専用のcritic定義、判定基準のファイル固定、PASS/FAILの機械判定、修正2回上限と隔離まで、実際に運用している構成を解説します。www.tentspace.net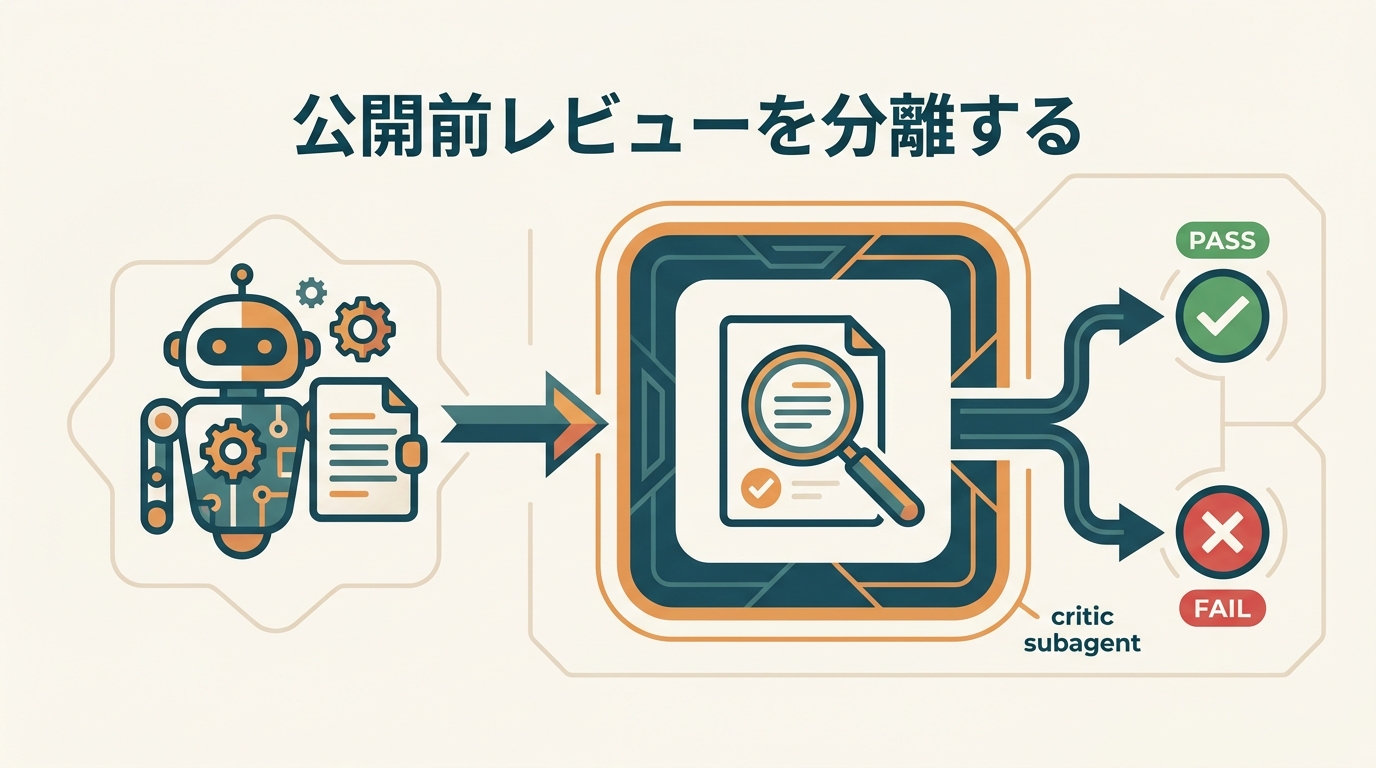
3つ目、単発ではなく累積で見る層。投稿ツール自体は1回1回正しく呼べても、放っておくと公開し過ぎる。この制限はプロンプトではなく自作MCPサーバー側に置いていて、Cloudflare WorkersのKVで全チャネル合算の回数上限を数えています。1本ごとの合否ではなく累積で止める発想は、Agent Anomaly Detectionの「セッション横断で累積を見る」と同じ向きです。
自作MCPサーバーに「投稿し過ぎない」制限を実装した記録|制限はプロンプトではなくサーバーに置くAIエージェントに投稿ツールを渡すと放っておくと公開し過ぎます。その制限をプロンプトではなく自作MCPサーバー側(Cloudflare WorkersのKV)に置いた実装記録。単純なカウントではなくreserve→commit/releaseの二段階にした理由と、失敗時に枠を戻す設計まで解説します。www.tentspace.net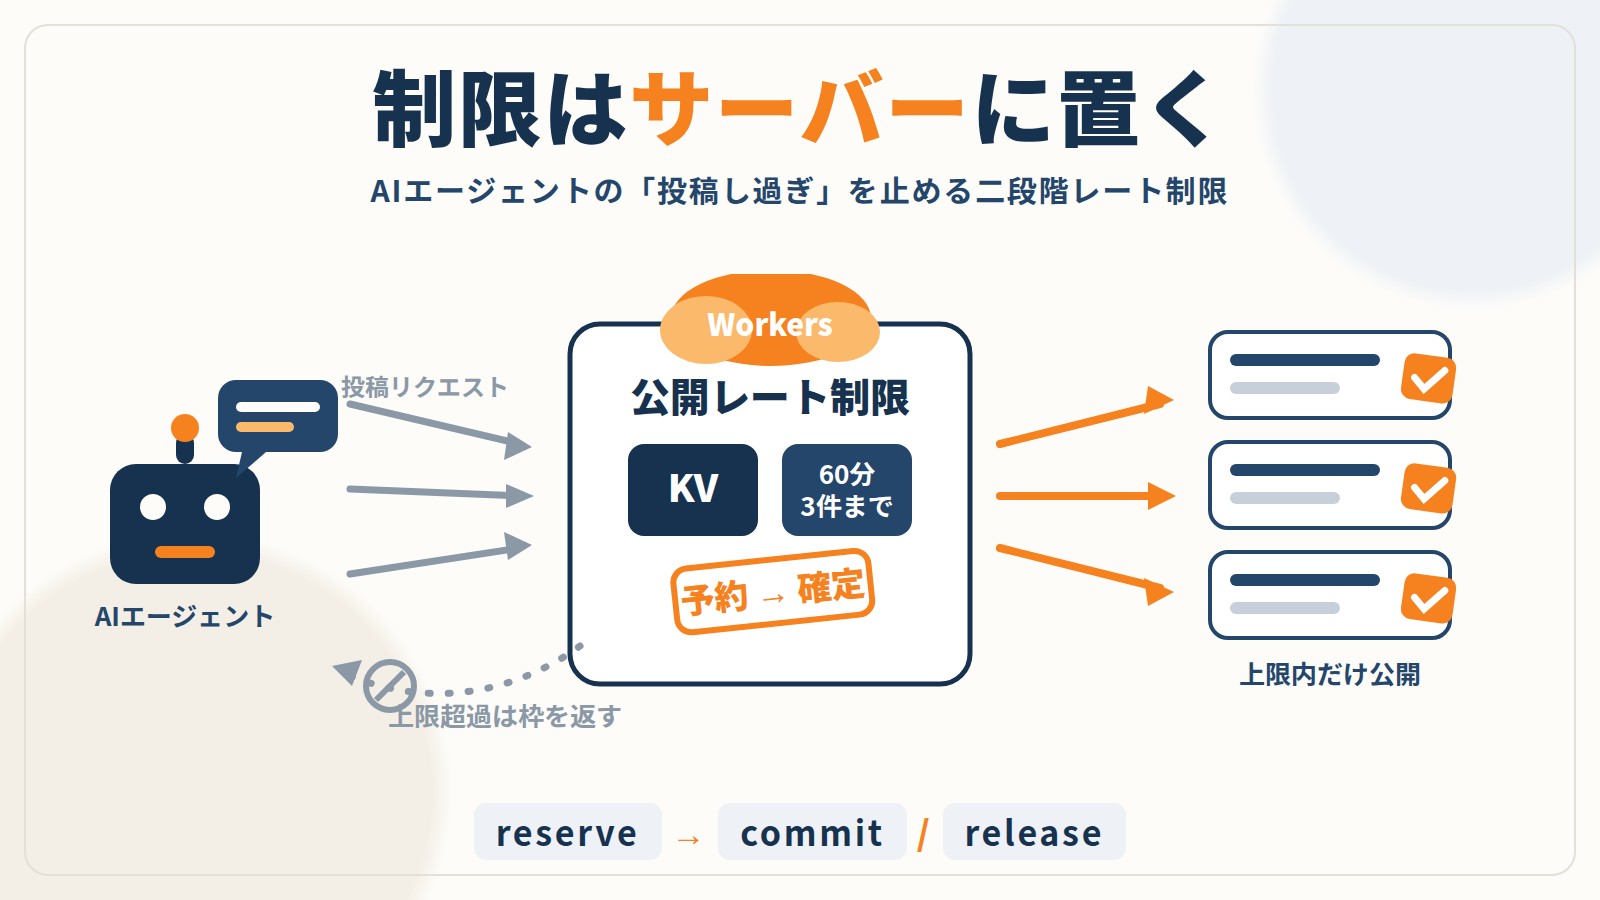
そして摩擦の話も他人事ではありません。Worker側に公開回数の上限を集約した構成では、上限判定で止まった正当な投稿をどう扱うかが最初から論点になります。私の場合は、止まった事実をSlackへ自動通知し、枠の予約と解放を二段階にして失敗時に枠を戻す設計にしました。形は違っても、「止まったことがすぐ見える」「正当なものを通す経路が楽」という要件は、Googleの摩擦報告が挙げた対応と同じところに落ちます。
使うか、使わないか——強制点の置き場所だけ先に決める
判断をまとめます。Agent Gatewayそのものは、私は使いません。Gemini Enterprise前提のプラットフォーム機能で、私の規模——運用者1人、エージェント数本——では、入口層を製品としてもう1枚増やす理由がないからです。
一方で、この設計が問うていること自体は、規模に関係なく答える必要があります。エージェントの安全対策を、エージェントのプロンプトやコードの中に書くのか、エージェントの外の共通の通過点に置くのか。私の答えは後者で、hooksとcriticとWorker KVという3つの小さな強制点に分けて置いています。プロンプトは変わり続けますが、通過点は変わらないからです。
ゲートウェイ製品が合理的になるのは、エージェントを作るチームが複数あり、ポリシーの管理主体を開発から分離することが組織要件になり、監査のためにすべての呼び出しを1か所で記録する必要が出てきたときだと考えています。逆に、運用者が1人でエージェントの数が少ないうちは、製品を入れるより「決定的に落とす縁・自然言語の審査・累積の上限」を自分のスタックの通過点に薄く置くほうが、摩擦のコストまで含めて安くつきます。
どちらを選ぶにしても、先に決めるべきは製品ではなく強制点の置き場所です。「事前に書けない違反を、実行時のどこで受けるか」。この問いに答えを持っていれば、Agent Gatewayのような製品が自分に必要かどうかは、規模が教えてくれます。