
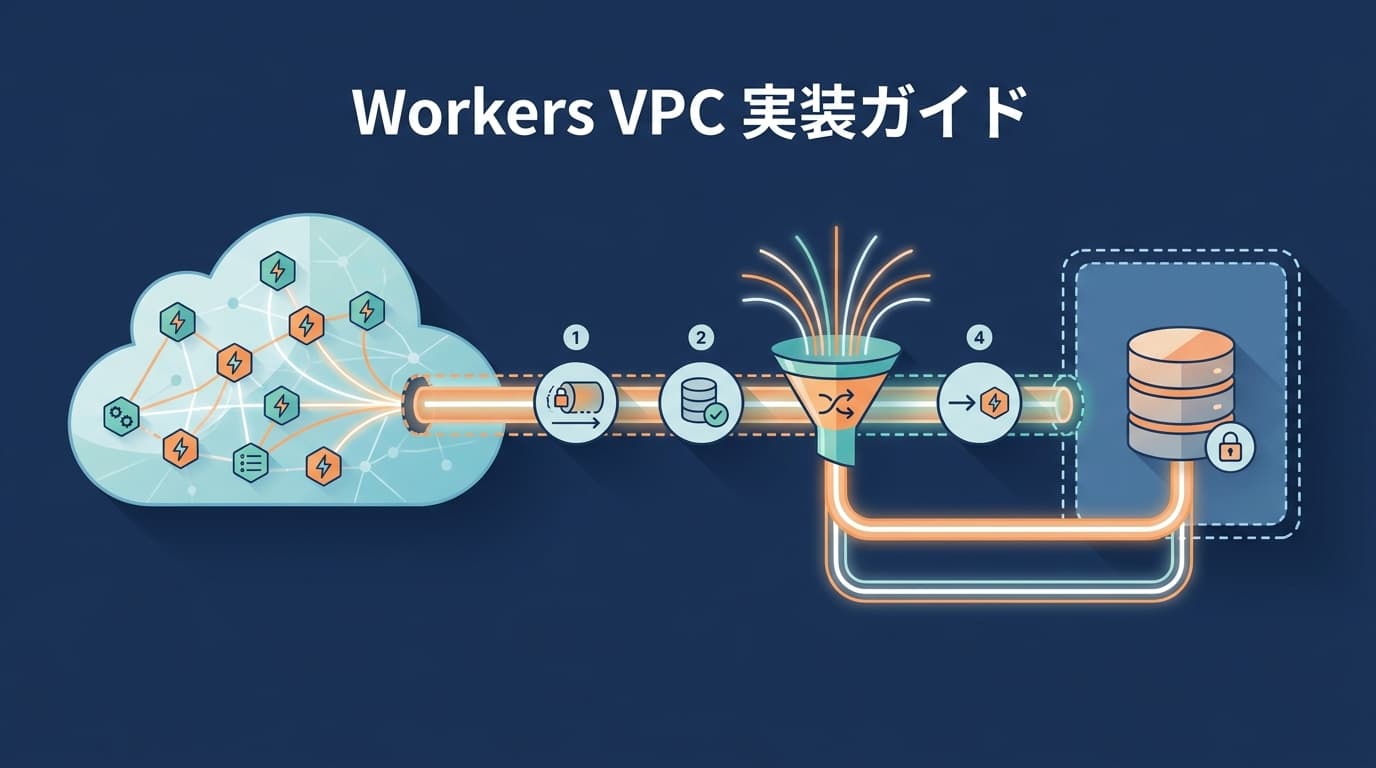
Workers VPCの実装は「トンネル → VPC Service → Hyperdrive → Worker」の4段で構成できます。コマンドの数は多くありません。それより先に決めておくべきは3つの設計判断で、(1) VPC ServicesとVPC Networksのどちらでバインドするか、(2) Hyperdriveを挟む構成を前提にするか、(3) 経路が落ちたときの振る舞いをどうするか。この記事は、その4段の流れと3つの判断を実装前に整理するためのガイドです。
対象読者は、Workers VPCの概要は掴んでいて、次に「実際に組むとしたら何をどの順で決めるのか」を知りたいエンジニアです。構成の全体像やAWSのVPN構成との比較は、前回の検討記事にまとめてあります。この記事は、その続きとして実装側へ踏み込みます。
Workers VPCでオンプレDBに接続する|AWSのVPN構成と何が違うかオンプレや私設ネットワークのDBをサーバーレスから使う方法を整理します。Cloudflare Workers VPCとHyperdriveによる接続手順、AWSでVPN/Direct Connectを組む場合との構成の落差、Tailscaleとの棲み分けまで、検討過程の判断を記録します。www.tentspace.net
なお、Workers VPCは2026年8月の確認時点でオープンベータの機能です。仕様やコマンドの形は変わる可能性があるため、実際に組む前に一次情報を必ず確認してください。
全体像: 4つの部品が1本の経路になる
まず、登場する部品と役割を1分で整理します。
- cloudflared: 私設ネットワークの内側に置くコネクタのプロセス。内側から外向き(outbound 443)にトンネルを張るので、インバウンドポートの開放、固定IP、ファイアウォールの変更が不要です
- VPC Service: 「このトンネルの先にある、このホスト:ポート」をCloudflare側に登録したもの。DBなら
--type tcpで登録します - Hyperdrive: WorkerとDBの間に入るコネクションプール。接続文字列の向き先をVPC Serviceにすることで、私設DBへの経路が完成します
- Worker: アプリ本体。
pgやmysql2をいつも通り使い、Hyperdriveから渡される接続情報を使うだけです
経路を文字にすると「Worker → Hyperdrive → トンネル → cloudflared → DB」。Workerから見えるのはHyperdriveだけで、トンネルの存在はコードに現れません。ここが後で効いてくるポイントです。
Cloudflare公式ドキュメント: Workers VPCSecurely connect your private cloud to Cloudflare to build cross-cloud apps.developers.cloudflare.com
実装の4段: 中核はコマンド1つ
手順の骨格は次の4段です。
1段目: トンネルを張る。 私設ネットワーク内のマシンにcloudflaredを入れ、トンネルを作成して起動します。DBそのものには何も入れません。cloudflaredが動くマシンからDBへTCPで届けばよいので、DBサーバーと同居させる必要もありません。
2段目: DBをVPC Serviceとして登録する。 ここが中核で、コマンドは1つです。
npx wrangler vpc service create my-postgres-db \
  --type tcp --tcp-port 5432 --app-protocol postgresql \
  --tunnel-id <TUNNEL_ID> --ipv4 10.0.0.5
トンネルIDと、トンネルの内側から見たDBのプライベートIP・ポートを指定します。--app-protocol はpostgresqlまたはmysqlで、Hyperdrive経由の私設DB接続が対象にするのもこの2つです。
3段目: Hyperdrive設定を作る。 通常のHyperdriveは公開エンドポイントの接続文字列を渡しますが、私設DBの場合は向き先を2段目のVPC Serviceにします。この構成は2026年4月末のchangelogで正式化された公式推奨ルートです。具体的な設定手順は公式ガイドが一次情報です。
Hyperdrive: Connect to a private database using Workers VPCWorkers VPC provides a way to connect Hyperdrive to a private database without configuring Cloudflare Access applications or service tokens. Instead, you create a TCP VPC Service that points to your database and pass its service ID to Hyperdrive.developers.cloudflare.com4段目: Workerから繋ぐ。 wrangler設定にHyperdriveのバインディングを足し、コードでは pg や mysql2 にHyperdriveの接続情報を渡します。ドライバから見ると普通のDB接続なので、既存のクエリコードはそのまま動く形になります。
4段のうち、アプリのコードに触るのは4段目だけ。1〜3段目はすべてインフラ側の登録作業です。この分離のおかげで、「まずローカルの公開DBで動かして、後から私設DBへ切り替える」という段階的な進め方もできます。
判断1: VPC ServicesとVPC Networks、どちらでバインドするか
Workers VPCには2つのモードがあります。ホスト:ポート単位でバインドするVPC Servicesと、トンネルやCNI全体にバインドして connect() で生TCPを話せるVPC Networksです。
DB接続なら基本はVPC Servicesです。理由は2つあります。届く範囲が「登録したホスト:ポート」に限定されるので、トンネルを張った先のネットワーク全体へWorkerから届いてしまう状態を避けられること。そしてHyperdriveと組み合わせる公式ルートがVPC Servicesを前提にしていることです。
VPC Networksを選ぶのは、登録型では追いつかない場合です。接続先が動的に変わる、対象が多すぎて個別登録が現実的でない、PostgreSQL/MySQL以外のプロトコルを話したい。そういう要件が実際にあるかを先に確認して、なければServicesに寄せる。個別登録の手間は、そのまま「どこへ届くかの台帳」になるので、私は手間ではなく管理機能だと捉えています。
判断2: 経路の設計だと思っていたら、寿命の設計だった
実装前の検討で一番認識が変わったのはここです。Workers VPCの検討はネットワーク経路の話として始まります。トンネルをどう張るか、どこに届くようにするか。ところが構成を詰めていくと、実装判断の中心は経路ではなく、DBコネクションの寿命管理にありました。
Workerは短命な実行環境で、自前で長生きするDBコネクションを保持できません。つまりトンネルだけ張ってWorkerから直接DBへ繋ぐ構成にすると、リクエストのたびに接続確立のコストを払い、スケール時にはDB側の接続数が読めなくなります。オンプレや私設のDBは、クラウドのマネージドDBほど接続数の上限に余裕がないことも多い。
だからこの構成では、Hyperdriveは「挟んでもいいオプション」ではなく実質的な本体です。Hyperdrive側がプールをホットに保ち、DBから見ると「Cloudflareのプールから、安定した少数の接続が来ている」状態になる。Workerが世界中で何千インスタンス起きても、DB側の接続数は爆発しません。エッジ側のスケールとDB側の接続数保護が仕組みとして両立します。プーリングがトンネル越しにどう実現されているかは、Cloudflareのエンジニアリングブログに設計背景が書かれています。
Cloudflare Blog: How Hyperdrive connects to databases inside your VPC networksHyperdrive (Cloudflare’s globally distributed SQL connection pooler and cache) recently added support for directing database traffic from Workers across Cloudflare Tunnels. We dive deep on what it took to add this feature.blog.cloudflare.com

設計判断としてはこう整理できます。「Workers VPCを使うか」を検討しているつもりでも、実際に決めているのは「DB接続の寿命管理をどこに置くか」。この視点で見ると、接続文字列をどこで管理するか、プールの向こうでDB側のmax_connectionsをいくつ残すか、といった検討項目が自然に出てきます。
判断3: 落ちたときの振る舞いを先に決める
エージェント型の接続は軽い分、経路の生死がcloudflaredという1プロセスに乗ります。実装前に決めておきたいのは次の3点です。
- cloudflaredの常駐管理: プロセスが死ねば経路も死にます。OS側のサービス管理(systemdなど)で自動再起動を組み、プロセス監視を最初から設計に入れる。トンネルを冗長化できるかは導入時点のドキュメントで確認してください(この部分は私は未検証です)
- エラーの切り分け手順: 障害時に「Worker側か、Hyperdrive側か、トンネル側か、DB側か」を切り分ける順番を先に書いておく。経路の部品が増えた分、当てずっぽうの調査は時間を溶かします。Workerから見えるのはHyperdriveまでなので、トンネルより先の疑いはcloudflared側のログから見るのが素直です
- ベータ期間の扱い: オープンベータの機能を本番のデータパスに置くかどうかは、それ自体が判断です。段階を分けるなら、まず社内ツールや読み取り系のワークロードで経路を運用し、挙動を掴んでから書き込み系を乗せる順番が安全側です
ロードマップとしてはIPsec・CNI・AWS Transit Gateway対応や双方向化がオープンベータ発表で言及されています。回線型との併用や移行を考えている場合は、この発表を読んでから判断するのがよいです。
Cloudflare Blog: Workers VPC now in open betaWorkers VPC Services enter open beta today. We look under the hood to see how Workers VPC connects your globally-deployed Workers to your regional private networks by using Cloudflare's global network, while abstracting cross-cloud networking complexity.blog.cloudflare.com
実装前チェックリスト
最後に、この記事の判断をチェックリストの形にまとめます。
- 接続したいDBはPostgreSQLまたはMySQLか(Hyperdrive経由の私設DB接続の対象はこの2つ)
- 接続先は固定的か(固定ならVPC Services。動的・多数・他プロトコルならVPC Networksを検討)
- DB側のmax_connectionsに、Hyperdriveのプール分をどれだけ割り当てるか
- cloudflaredをどのマシンで動かし、誰が再起動と監視に責任を持つか
- 障害時の切り分け順を、経路の部品ごとに書き出したか
- オープンベータの機能を、どのワークロードから順に乗せるか
4段の手順そのものは半日あれば試せる規模のはずです(この規模感は環境によって差があります)。差が出るのは手順ではなく、判断1〜3を先に済ませてあるかどうか。特に判断2の「経路ではなく寿命の設計」という視点は、Workers VPCに限らず、サーバーレスからステートフルな資産へ繋ぐ構成すべてで使い回せます。
変更履歴の一次情報はこちらです: Hyperdrive can now connect to private databases in your VPC(Cloudflare changelog, 2026-04-29)